Werbung: Dieser Beitrag enthält Affiliate-Links (mit * markiert). Kaufst du darüber etwas, bekomme ich eine kleine Provision – der Preis bleibt für dich gleich.
Lokale KI auf älterer Hardware: Was leistet eine GTX 1050?
Wenn du einen älteren Laptop mit einer Nvidia GeForce GTX 1050 (4 GB VRAM) besitzt, fragst du dich sicher, ob sich darauf überhaupt eine lokale KI betreiben lässt. Die kurze Antwort lautet: Ja, das klappt erstaunlich gut, solange du zu kleineren Sprachmodellen greifst.
Um herauszufinden, wie schnell verschiedene Modelle auf dieser Grafikkarte arbeiten, hilft ein Blick auf die konkreten Messwerte. Schließlich möchtest du nicht ewig auf eine Antwort warten.
Aktualisiert am 24.10.2026: Vier weitere Modelle gemessen (llama3.2:1b, qwen2.5:1.5b, phi4-mini, gemma3:4b), dazu die Ladezeiten.
Tipp: Welche Modelle auf deinem Gerät laufen, zeigt der Rechner Läuft das bei mir?.
Die Messmethode: So findest du deine Tokens pro Sekunde heraus
Ollama bringt von Haus aus alles mit, was du für einen Geschwindigkeitstest brauchst. Du musst keine extra Software installieren.
Starte dein Terminal oder die Eingabeaufforderung und füge den Zusatz --verbose an deinen Befehl an. Damit zwingst du Ollama, nach der Antwort eine detaillierte Statistik auszugeben.
ollama run llama3.2:3b --verbose
Am Ende der Ausgabe siehst du verschiedene Werte. Für uns ist vor allem die Zeile mit den eval rate oder den Tokens pro Sekunde interessant. Sie zeigt dir genau, wie flüssig das Modell die Wörter generiert.
Wie das Modell zwischen Grafikkarte und Prozessor aufgeteilt ist, zeigt dir ein zweiter Befehl, solange das Modell noch geladen ist:
ollama ps
In der Spalte PROCESSOR steht dann zum Beispiel „100% GPU“ oder „25%/75% CPU/GPU“.
Messwerte: Modelle, Größe und Geschwindigkeit im Vergleich
Getestet habe ich auf meinem MSI-Laptop (GTX 1050 mit 4 GB, i7-7700HQ, 32 GB RAM). Damit die Werte vergleichbar sind, hat jedes Modell dieselbe Frage bekommen („Erkläre in etwa 200 Wörtern, warum der Arbeitsspeicher für lokale KI auf einem Laptop wichtig ist.“), mit gleichen Einstellungen: höchstens 256 Tokens Antwort, 4096 Tokens Kontext, Temperatur 0. Jedes Modell lief nach einer Aufwärmrunde zweimal, in der Tabelle steht der Mittelwert. Die Ladezeit ist der erste Start des Modells.
Bei mir sind außerdem zwei Ollama-Einstellungen aktiv, die Grafikspeicher sparen: OLLAMA_FLASH_ATTENTION=1 und OLLAMA_KV_CACHE_TYPE=q8_0. Ohne diese Einstellungen können deine Werte etwas niedriger ausfallen.
| Modell | Größe im Speicher | Tokens pro Sekunde | GPU-Anteil | Ladezeit |
|---|---|---|---|---|
| llama3.2:1b | 1,4 GB | 44,9 t/s | 100 % GPU | 6,3 s |
| qwen2.5:1.5b | 1,0 GB | 36,9 t/s | 100 % GPU | 5,2 s |
| deepseek-r1:1.5b | 1,0 GB | 36,4 t/s | 100 % GPU | 5,3 s |
| llama3.2:3b | 2,2 GB | 24,0 t/s | 100 % GPU | 7,5 s |
| phi4-mini | 3,2 GB | 16,6 t/s | 72 % GPU / 28 % CPU | 10,6 s |
| qwen3:4b-instruct | 3,0 GB | 14,5 t/s | 75 % GPU / 25 % CPU | 10,3 s |
| gemma3:4b | 3,2 GB | 11,9 t/s | 50 % GPU / 50 % CPU | 9,0 s |
| gemma4:e4b | 8,8 GB | 8,6 t/s | 16 % GPU / 84 % CPU | 22,2 s |
| qwen2.5:7b | 4,7 GB | 6,5 t/s | 48 % GPU / 52 % CPU | 17,4 s |
| hermes3:8b | 4,8 GB | 6,5 t/s | 47 % GPU / 53 % CPU | 17,2 s |
Die Größen sind in GiB angegeben (so rechnet Windows). ollama ps zeigt dieselben Modelle mit etwas höheren Zahlen an, zum Beispiel 5,0 GB statt 4,7 GB bei qwen2.5:7b. qwen2.5-coder:7b verhält sich genauso wie qwen2.5:7b, deshalb fehlt es in der Tabelle.
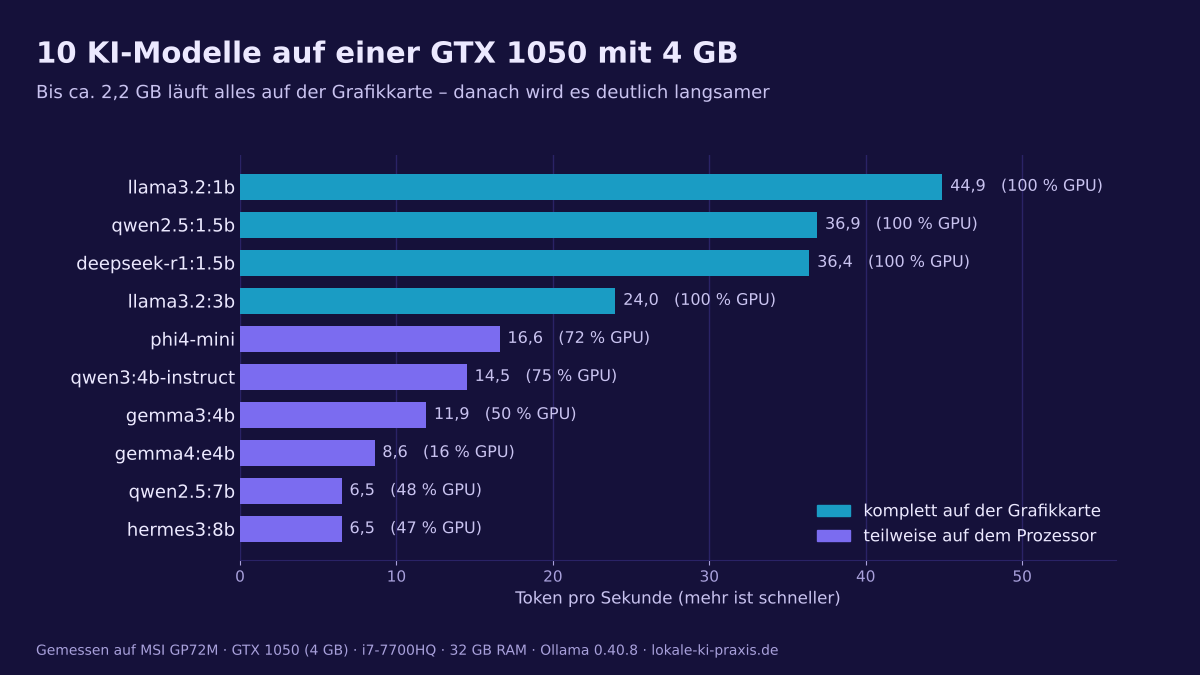
Bis etwa 2,2 GB passt das Modell bei mir komplett in die Grafikkarte und schafft über 20 Tokens pro Sekunde. Am schnellsten ist llama3.2:1b mit fast 45 Tokens pro Sekunde – damit fühlt sich die Antwort praktisch sofort an. Für die meisten Aufgaben ist llama3.2:3b mit 24 Tokens pro Sekunde der bessere Kompromiss, weil es spürbar mehr versteht.
Ab etwa 3 GB wird es knapp: phi4-mini und qwen3:4b liegen zu rund drei Vierteln auf der Grafikkarte und schaffen 15 bis 17 Tokens pro Sekunde – zum Chatten immer noch angenehm. gemma3:4b ist ähnlich groß, landet aber nur zur Hälfte auf der Grafikkarte und ist mit knapp 12 Tokens pro Sekunde deutlich langsamer.
Die 7B- und 8B-Modelle teilt Ollama etwa zur Hälfte auf Grafikkarte und Prozessor auf – dann sind es nur noch 6 bis 7 Tokens pro Sekunde. gemma4:e4b fällt aus der Reihe: Es belegt 8,8 GB, läuft zu 84 % auf dem Prozessor und ist mit 8,6 Tokens pro Sekunde trotzdem etwas schneller als die 7B-Modelle.
Sobald ein Modell größer ist als dein Videospeicher, lagert Ollama Teile in den Arbeitsspeicher (RAM) aus. Das bremst die Geschwindigkeit drastisch aus. Achte daher darauf, dass das Modell möglichst vollständig in den VRAM passt.
Achtung: Wenn der Arbeitsspeicher voll ist und die GPU überläuft, bricht die Leistung ein. Halte die Modelle klein, um flüssig arbeiten zu können.
Übrigens: Bei meiner Messung hat Ollama auf der 4-GB-Karte nie mehr als rund 2,3 GB für das Modell genutzt, obwohl laut nvidia-smi noch gut 1,5 GB frei waren. Wie du diesen Platz trotzdem nutzen kannst und damit bis zu 51 % mehr Tempo herausholst, zeige ich im Artikel Ollama nutzt deine 4-GB-Grafikkarte nicht voll.
Einfluss von Wärme und Kühlung
Ältere Laptops neigen unter Dauerlast schnell dazu, warm zu werden. Wenn die GTX 1050 zu heiß läuft, drosselt sie automatisch ihre Leistung (Thermal Throttling). Das spürst du sofort an sinkenden Tokens pro Sekunde.
Achte darauf, dass die Lüftungsschlitze frei bleiben. Ein Laptopständer hebt das Gerät an, damit mehr Luft an die Unterseite kommt. Eine bessere Luftzufuhr schützt die Hardware und sorgt dafür, dass die KI bei längeren Chats nicht plötzlich langsamer wird. Wer viel tippt oder schreibt, kann zudem über eine ergonomische Tastaturen bei Coolblue* nachdenken, um den Arbeitsplatz aufzuwerten.
Wenn dein Laptop für lokale KI zu langsam ist: Was sich beim Aufrüsten wirklich lohnt, steht in der Übersicht zum Aufrüsten. Und wenn ein neues Gerät her soll: Welche Grafikkarte wie viel Grafikspeicher hat, zeigt die Kaufberatung nach Grafikspeicher.
Unsere Partner
Werbung: Die Banner und Knöpfe hier sind Partnerlinks. Kaufst du darüber etwas, bekomme ich eine kleine Provision – der Preis bleibt für dich gleich. Als Amazon-Partner verdiene ich an qualifizierten Verkäufen.
Hi, ich bin Cengiz.
Auf meinem alten Gaming-Laptop mit GTX 1050 (4 GB) habe ich mir einen eigenen KI-Assistenten mit Sprachsteuerung gebaut – mit Ollama und Open WebUI, ganz lokal. Hier schreibe ich auf, was auf älterer Hardware wirklich läuft und was nicht. Jeder Artikel ist von mir geprüft und freigegeben.
Mehr über mich und den Blog · ▶ Meine Videos auf YouTube